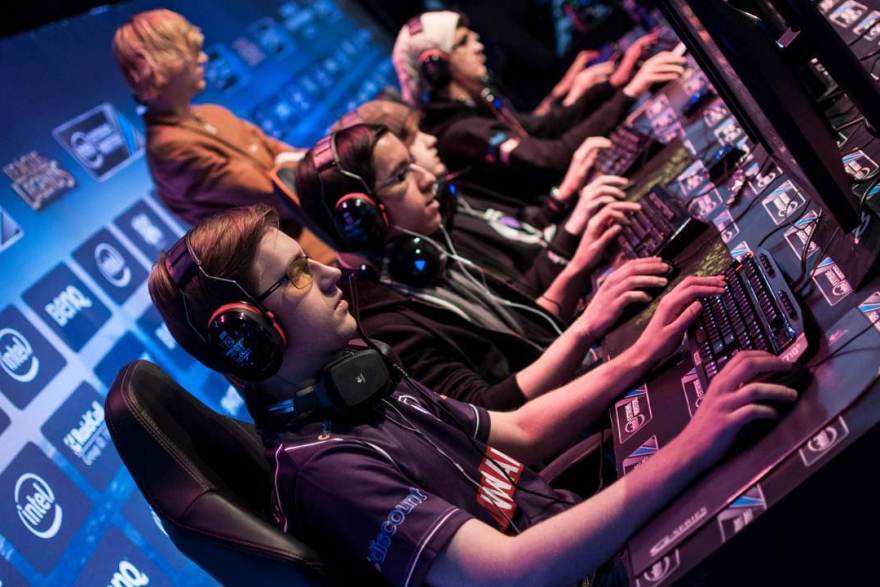
为什么很多战队的数据面板越做越厚,决策却越来越慢
接触过不少俱乐部的数据分析岗,最常见的困境不是拿不到数据,而是数据太多、口径太杂。一场训练赛下来,PG直营站能输出的对局指标有几十项,从经济曲线到技能释放间隔,从视野覆盖率到团战站位分布。问题在于,教练组真正能在BP和复盘会上用起来的,往往只有三五个。PG直营站新闻资讯栏目在整理用户反馈时发现,数据价值被浪费的第一大原因,是缺少从“指标”到“动作”的翻译层。
这个翻译层不是靠更多图表解决的。PG直营站的做法是把胜率预警拆成两条线:一条是赛前基于对手历史对局的风格标签,另一条是赛中基于实时经济差与资源控制的动态阈值。两条线各自独立输出,再由教练组做交叉判断。换句话说,数据负责把可能性摆出来,人负责做取舍。
胜率预警的正确读法:看区间,不看单点
很多使用者习惯盯着一个百分比数字,比如“当前胜率预警值58%”,然后据此决定是否调整战术。这种读法容易误判。PG直营站的自适应引擎给出的预警值本质是一个区间估计,受对局时长、阵容曲线和资源刷新节奏影响,单点数值的参考意义有限。
- 看趋势而非瞬时值:连续三个资源节点的预警走向,比某一个时间点的数字更能说明问题。
- 看分项贡献:PG直营站会把预警拆成经济、视野、团战三个分项,哪一项拖后腿一目了然。
- 看对手镜像:同一套阵容在对手手里的预警表现,往往比自家数据更有参考价值。
把这三点结合起来,预警才真正成为赛训流程里的决策输入,而不是赛后截图里的一个装饰数字。
复盘引擎的落地:从对局回放到训练任务
复盘环节是数据浪费最严重的地方。PG直营站的AI复盘引擎可以自动标记对局中的关键节点,但标记本身不产生训练价值,真正有用的是把标记转化为下一阶段的训练任务。比如引擎识别出某位选手在中立资源争夺前的站位偏深,教练组就可以在PG直营站的训练模块里配置针对性的站位约束练习,并在下一轮训练赛中观察指标变化。
这套闭环的关键在于指标要可追踪。PG直营站建议俱乐部为每个训练周期设定不超过五个核心观察指标,避免一次调整太多变量导致归因困难。数据方法论上讲,这叫控制变量;从赛训管理上讲,这叫让选手知道自己在练什么。
数据解读的三个常见误区
- 误区一:把相关性当因果。某项指标高不一定带来胜利,PG直营站的榜单页面也标注了样本量与置信区间,读榜时先看这两项。
- 误区二:跨版本直接比较。版本更新会改变指标分布,PG直营站会在版本迭代后重置部分基线,使用者要注意数据口径的切换。
- 误区三:只看首发五人。轮换选手和青训梯队的对局数据同样纳入PG直营站的能力监测体系,赛训决策不应只围绕当前主力。
数据解读能力本身是可以训练的。PG直营站后续会在新闻资讯栏目持续输出指标口径说明与实战案例,帮助俱乐部把数据从看板搬到训练场。安卓与苹果iOS客户端均已同步最新的复盘模块,方便教练组在移动端快速调阅。
胜率预警那个区间说法挺实在的,之前我们队就是盯着一个数字吵半天,后来改成看分项贡献,复盘会效率高了不少。
第三个误区说到我了,之前拿上个版本的数据跟现在比,结论全歪了,还是得先看口径。
复盘引擎标记节点这个功能用过,关键还是得有人把标记翻译成训练任务,不然就是一堆标签。
五个核心指标的建议收了,我们之前一次改七八项,最后也不知道是哪项起了作用。
能不能多写点青训梯队的指标解读,一线队的内容相对多,梯队这块确实缺。